
Платформы управления AI-агентами обещают контроль, но часто оставляют компании внутри своего контура. Главная задача - получить переносимый слой политик и доказательств, который работает с любыми фреймворками, облаками и моделями. Без этого governance превращается в инструмент уд
VK Tech опубликовала детали реализации своей Data Lakehouse-платформы. Это помогает оценить, как именно отечественное решение справляется с хранением разнородных данных, потоковой обработкой и одновременной работой нескольких вычислительных движков без дублирования информации. Дл
Pinterest представил механизм partition finalization, который даёт downstream-потребителям явный сигнал о том, что данные за часовой интервал полностью загружены и больше не изменятся. Решение построено на связке Kafka, Flink и Iceberg и решает проблему, которая возникает при пер
Apache Iceberg 1.12.0 вышел после 777 коммитов от 142 участников. Релиз добавляет заметные улучшения в работу с Variant, геопространственными типами и потоковой обработкой удалений. Инженерам стоит оценить обновление, если в проектах уже используются semi-structured данные или пл
Debezium 3.7 стал общедоступным после трёх месяцев разработки. Релиз добавил три инкубационных коннектора, перевёл CockroachDB в стабильный статус и представил первую версию CLI. Инженерам стоит оценить обновление, если они используют Oracle или планируют интеграцию с новыми исто
StarTree добавил в Apache Pinot framework Custom Hash Function, который позволяет описывать сложные правила партиционирования прямо в конфигурации таблицы. Это решает проблему, когда Kafka и Pinot расходятся в способе расчёта номера партиции, из-за чего broker не может выполнять
VK Cloud построил Cloud Tracing на Jaeger-совместимом API и OpenTelemetry. Сервис принимает спаны от сотен независимых клиентов, хранит десятки терабайт и отдаёт данные через привычные Jaeger UI и Grafana. Выбор хранилища при этом свёлся к двум вариантам из шести заявленных бэкен
Вторая часть разбора Arenadata показывает, как потребитель Kafka получает данные, управляет отставанием и делит партиции. Понимание этих процессов помогает инженерам правильно настраивать poll-циклы, лимиты и группы, чтобы избежать простоев и растущего лага. Разбор фокусируется н
ИИ-модели уже генерируют backend и frontend по одному промпту, включая связки с Kafka, PostgreSQL и Redis. Однако на практике такой код часто содержит скрытые ошибки, которые проявляются только при реальной нагрузке. Разработчик по-прежнему нужен, чтобы эти ошибки найти и исправи
В системах с transactional outbox и Kafka ключ партиционирования по order_id не гарантирует причинно-следственный порядок событий. Transactional outbox - это шаблон, при котором события сначала записываются в отдельную таблицу внутри той же транзакции, что и бизнес-данные, а зате
Аналитика реального времени начинается с того, что данные попадают в хранилище с минимальной задержкой после появления в источнике. Для StarRocks таким мостом из Apache Kafka служит Routine Load, встроенный механизм непрерывной загрузки потока прямо в таблицу. В этой статье соберем рабочий пайплайн: продюсер шлет JSON-события заказов в Kafka, а StarRocks...
Наша школа проводит открытый вебинар по теме: "On‑line аналитика: как строить хранилище, которое пишет и считает одновременно" . Узнайте, как объединить потоковую загрузку и быстрые аналитические запросы без компромиссов, какие технологии реально работают в production и как строится потоковая архитектура (CDC → Kafka → Flink → StarRocks → BI). Приглашаем...
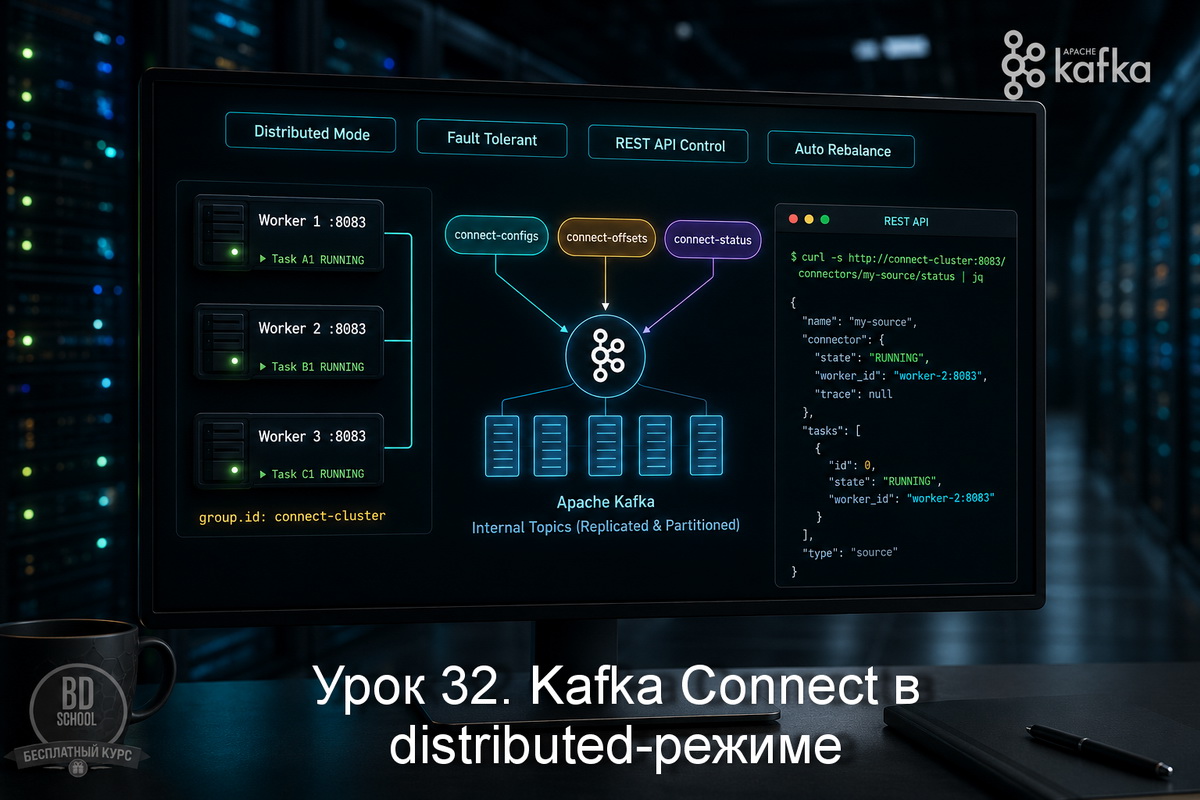
В уроке 31 мы разобрали standalone-режим Kafka Connect. Один процесс, конфигурация в файлах, офсеты на диске. Удобно для разработки, но в production такое не ставят: упал воркер — встали все коннекторы, и подхватить их некому. Distributed-режим решает именно это. Несколько воркеров объединяются в группу по group.id и синхронизируются через Kafka-топики....
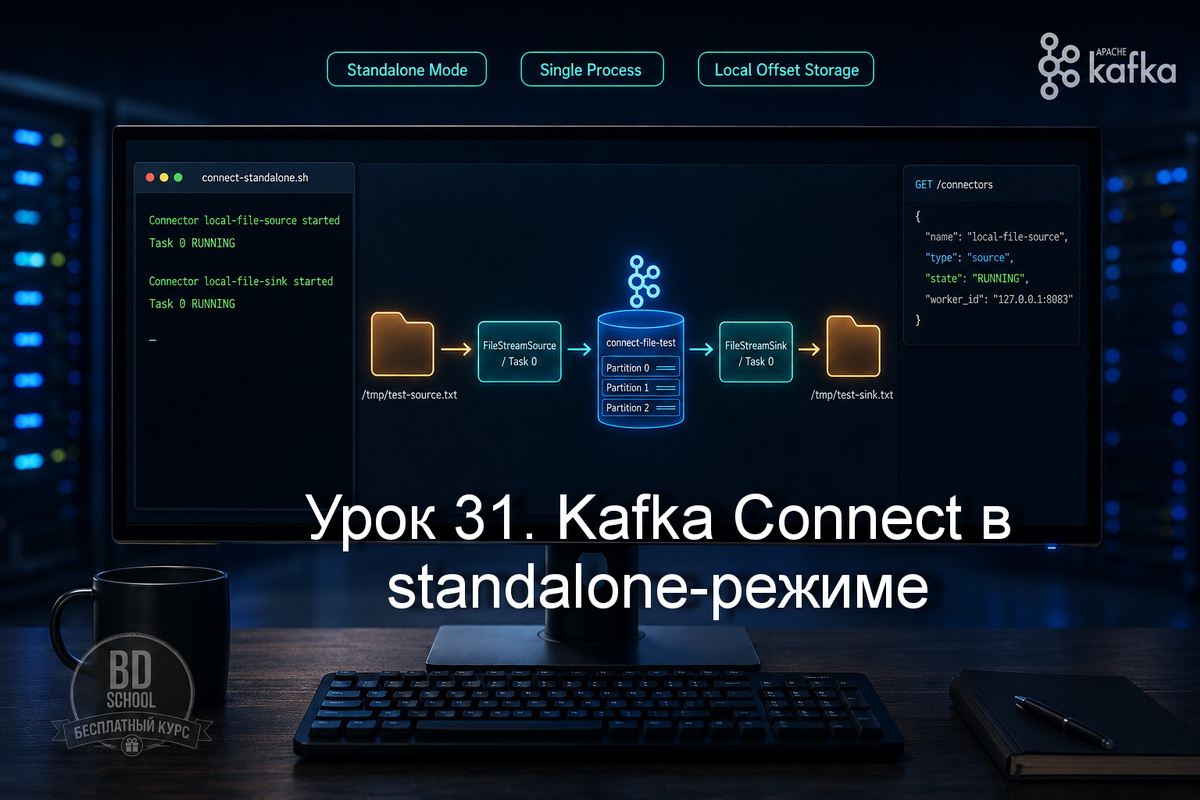
В уроке 30 разобрали MirrorMaker 2 - инструмент для репликации топиков между кластерами. Там мы мельком упоминали, что MM2 построен поверх Kafka Connect. Теперь пришло время разобраться с самим фреймворком. Kafka Connect - это слой интеграции, который берёт на себя всю рутину переноса данных между Kafka и внешними системами....
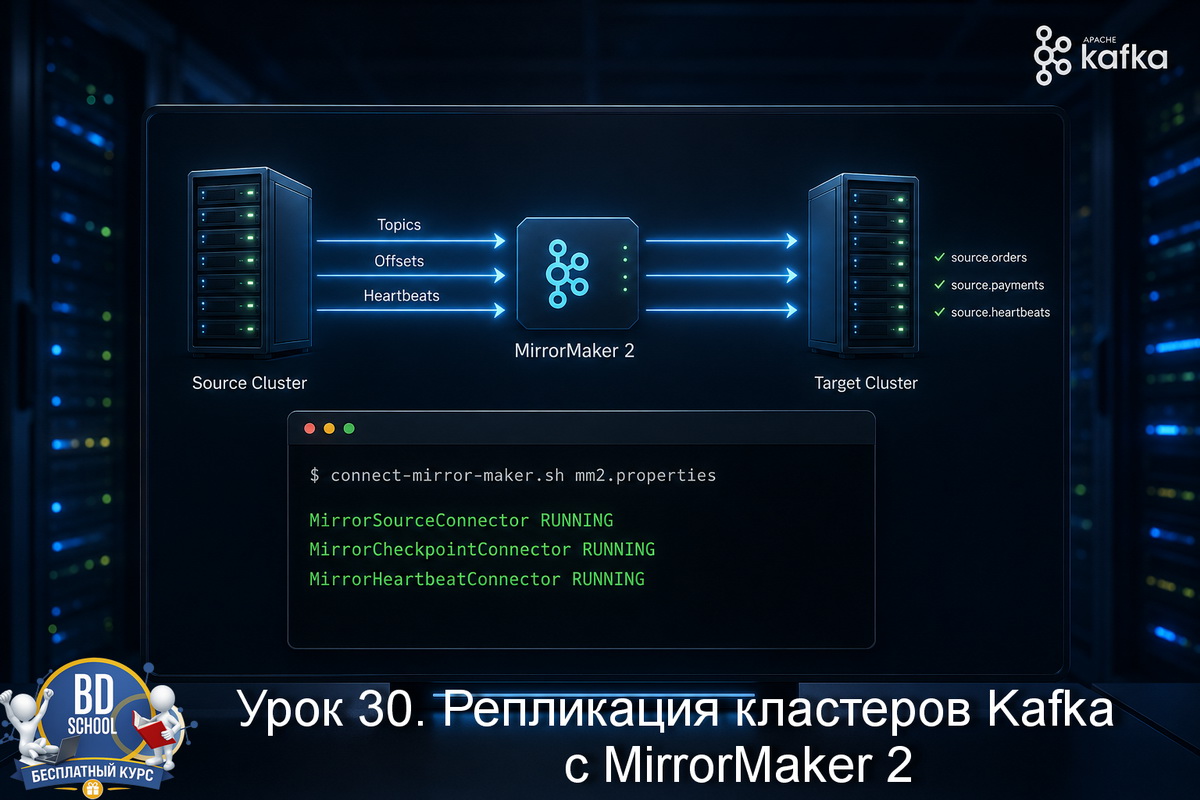
В уроке 29 мы разобрали kafka-consumer-perf-test.sh — как измерить скорость чтения, интерпретировать вывод и подбирать параметры консьюмера. Получили полную картину: есть цифры продюсера, есть цифры консьюмера, узкое место теперь видно. Следующий логичный вопрос: а что делать, если кластеров несколько? DR-окружение, географически распределённые датацентры, изоляция окружений prod и staging —...
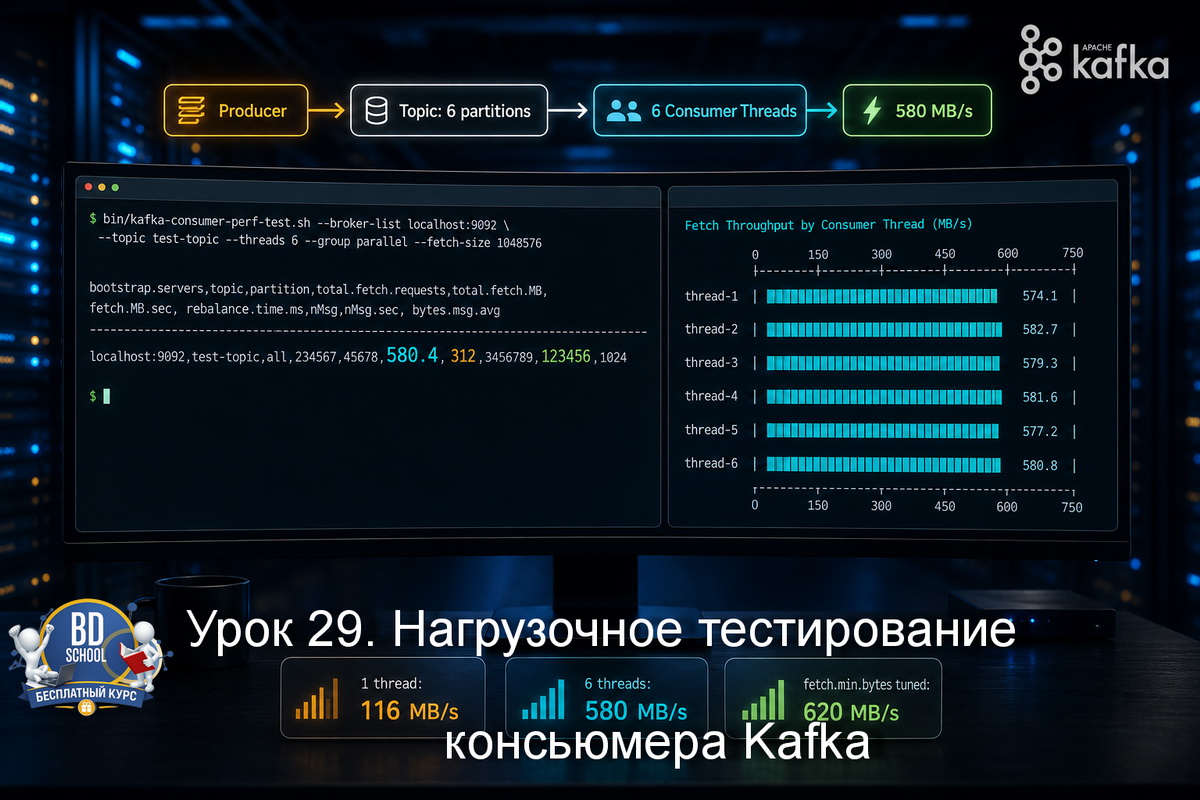
В уроке 28 мы разобрали kafka-producer-perf-test.sh: как гнать синтетическую нагрузку в топик, читать перцентили латентности и подбирать параметры продюсера. Получили цифры на стороне записи. Но у любого потока данных есть вторая сторона - чтение. И там своя картина. Узкое место системы не всегда продюсер. Часто потребитель не успевает за входящим...
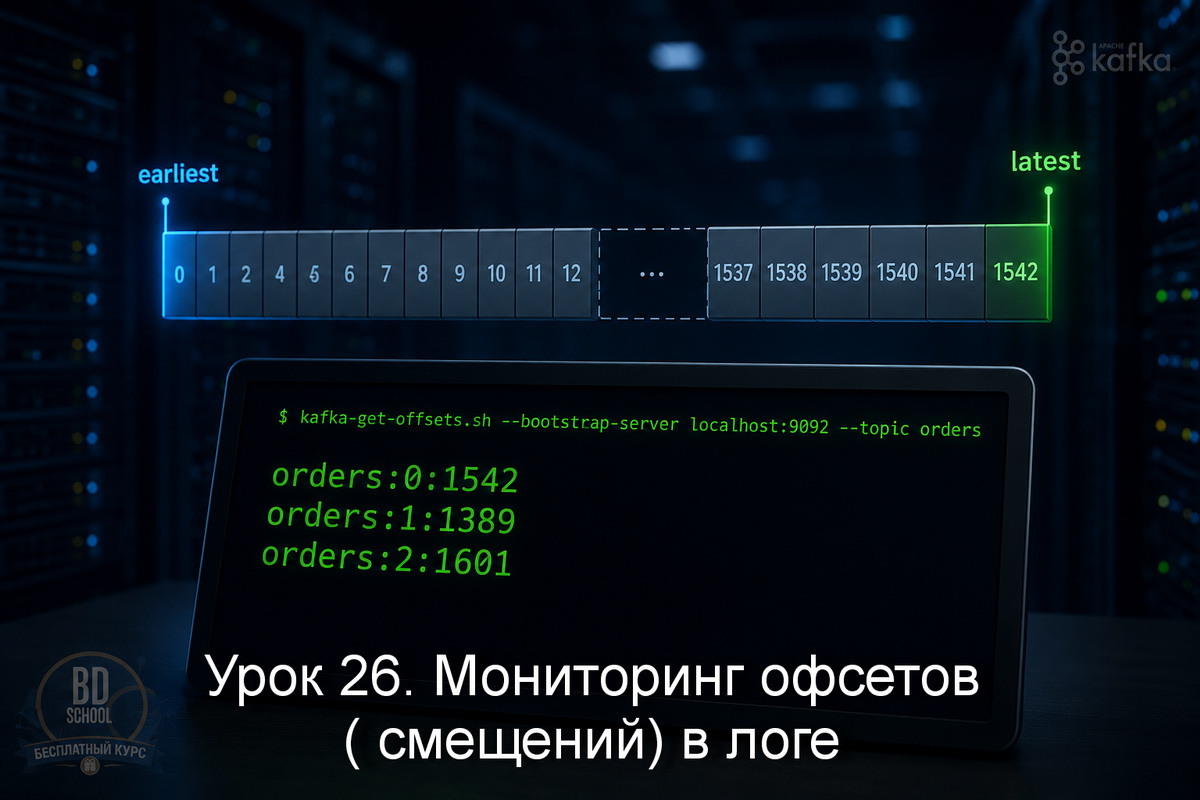
В уроке 25 мы разбирались с kafka-broker-api-versions.sh - смотрели, какие версии протокола поддерживает брокер, и учились диагностировать ошибки UNSUPPORTED_VERSION при rolling upgrade. Там речь шла о низкоуровневой совместимости на уровне API. Сегодня спускаемся на уровень ниже - не к протоколу, а к данным. Конкретно к офсетам. Любой, кто разбирается...
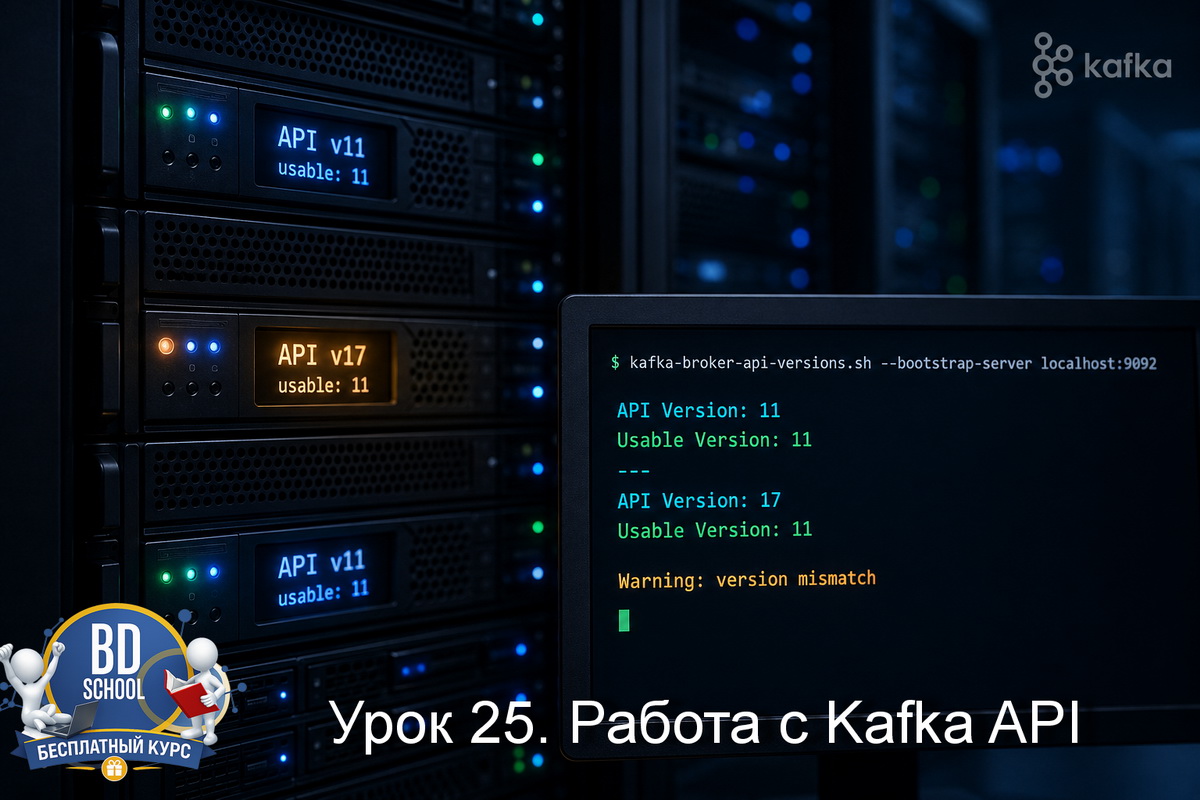
В уроке 24 мы разбирали kafka-acls.sh и работу со списками доступа: кто из клиентов что может делать с топиками, группами, кластером. Там же всплыл важный момент - аутентификация через SASL и флаг --command-config. Прежде чем клиент получит право что-то делать, он должен вообще договориться с брокером на уровне протокола....
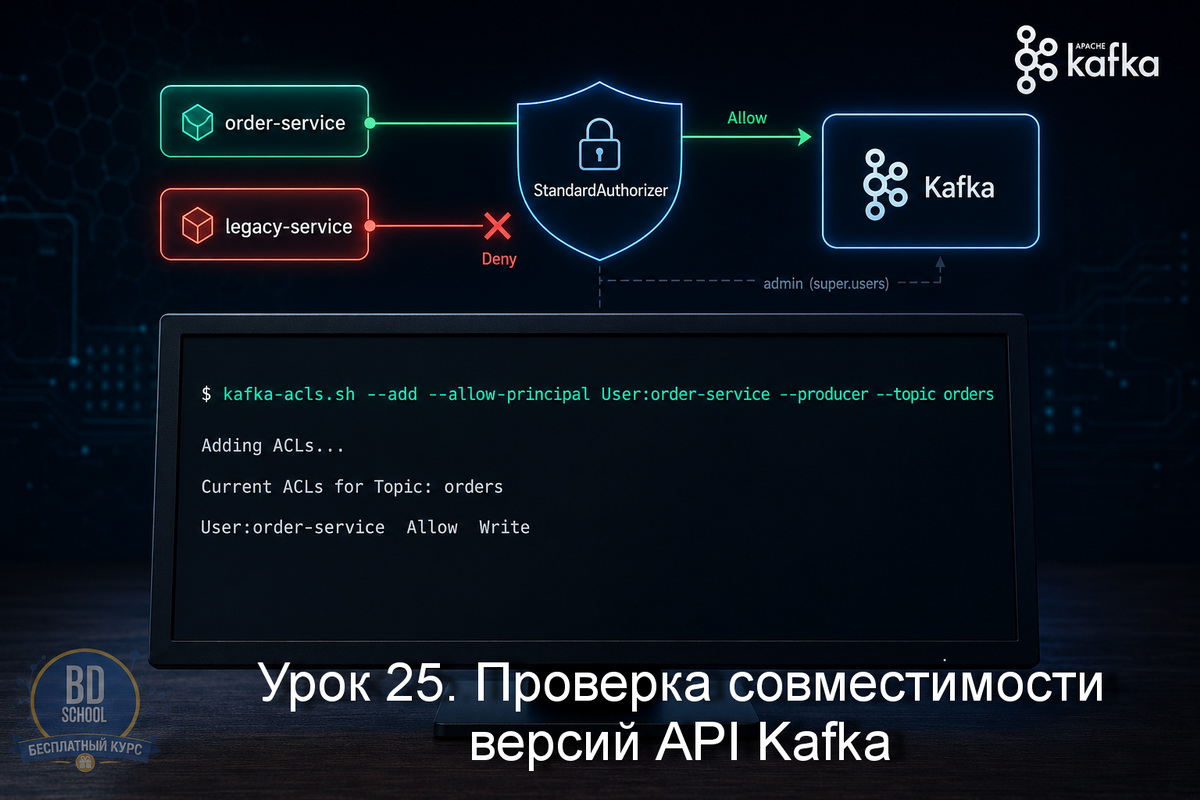
В уроке 23 мы разобрали kafka-replica-verification.sh - инструмент, который подключается к каждому брокеру напрямую и сравнивает смещения реплик. Там же мы отметили важную особенность: утилита общается с брокерами через Fetch API без каких-либо ограничений доступа. В реальном кластере это уже вопрос: а кто вообще имеет право подключаться? В production-окружениях...
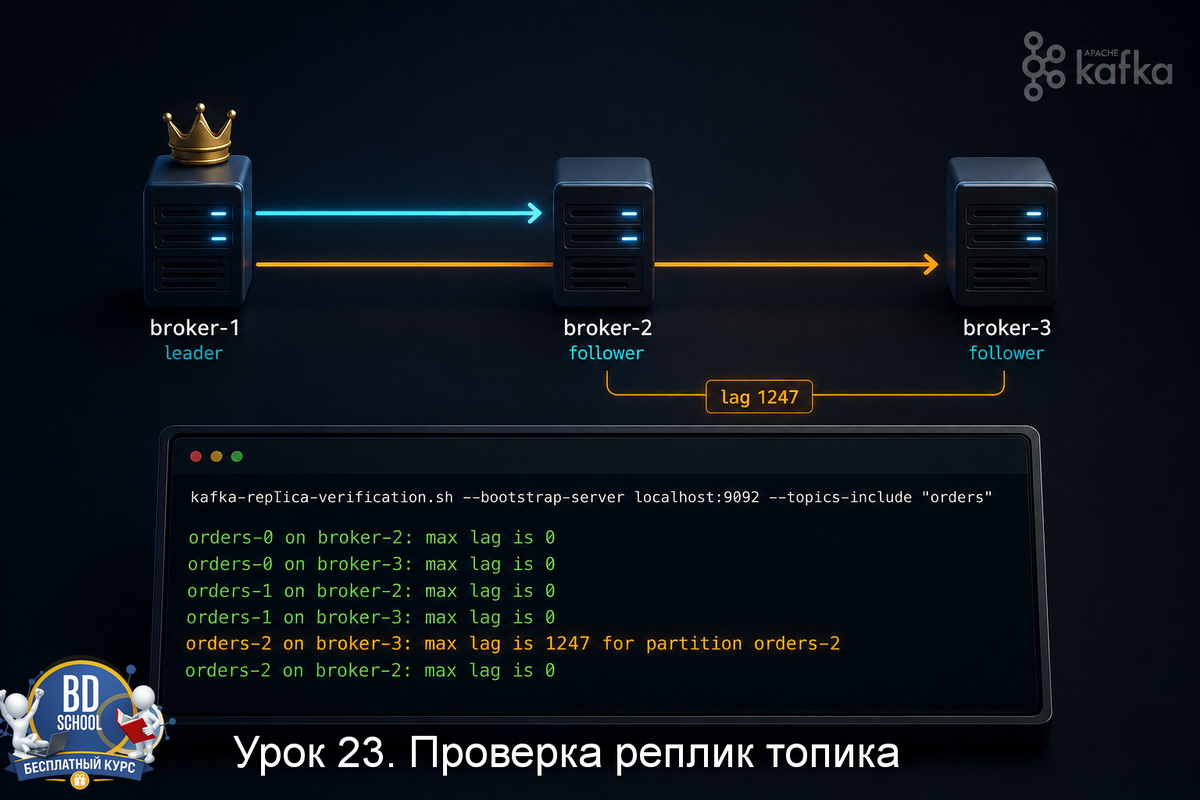
В уроке 22 мы разобрались с kafka-reassign-partitions.sh: генерировали план переноса партиций, запускали его с троттлингом и проверяли статус через --verify. После того как переназначение завершилось - данные физически переехали, реплики поднялись на новых брокерах. Но как убедиться, что данные во всех репликах одинаковые? Что ни одна реплика не отстала...